Så byggde vi en produktionsapp på Cloudflare Workers
16 april 2026
I vårt förra inlägg förklarade vi varför vi byggde Shrtnr och vad det ersatte. Det här inlägget går djupare in i arkitekturen: körmiljön, databasen och ramverksval som gör att det fungerar.
Shrtnr började som ett internt verktyg och blev ett öppen källkod-projekt för att arkitekturbesluten bakom det är värda att dela. Det här är stacken och resonemanget bakom den.
Problemet med att "bara deploya till en server"
De flesta URL-förkortare följer ett bekant mönster. En omdirigeringstjänst körs i en container eller på en VPS. Förfrågningar kommer in, träffar en applikationsserver, frågar en databas och returnerar en 301- eller 302-omdirigering. Det fungerar. Men det är också långsamt för alla som inte befinner sig geografiskt nära den servern.
Om en användare i Stockholm klickar på en kort länk, och servern står i USA, måste omdirigeringen korsa Atlanten innan den ens kan börja. Lägg till DNS-upplösning, TLS-handshake, applikationens uppslag och svarsresan tillbaka, och du tittar ofta på några hundra millisekunder innan webbläsaren börjar ladda den faktiska destinationen. För ett verktyg vars enda jobb är att komma ur vägen så snabbt som möjligt är det mycket tid spenderad på att göra ingenting användbart.
Vi ville ha något annorlunda. Varje omdirigering borde resolvas nära personen som klickar. Inget beroende av en centraliserad applikationsserver. Inga kalla starter. Arkitekturen behövde vara global som standard, inte genom konfiguration.
Cloudflare Workers: vad "körs på edge" faktiskt innebär
Shrtnr körs på Cloudflare Workers. Inte i en container. Inte på en VPS bakom en lastbalanserare. Det körs på edge-nätverket självt, distribuerat över 300+ platser globalt.
När någon klickar på en kort länk i Jakarta, Tokyo eller Stockholm hanteras förfrågan av en Cloudflare Worker som körs på närmaste edge-plats. Beräkningen sker nära användaren, vilket eliminerar den centraliserade applikationsservern ur ekvationen. I praktiken kan databasläsningar fortfarande innebära latens mellan regioner beroende på var din D1-data finns, men exekveringsmodellen eliminerar origin-server-flaskhalsen som gör traditionella förkortare långsamma.
Det här är inte bara ett prestandatrick. Det förändrar arkitekturen på alla nivåer. Workers är kortlivade, tillståndslösa request-hanterare utan filsystemsåtkomst och med strikta minnesbegränsningar. Du porterar inte en befintlig Node.js-app till Workers och hoppas på det bästa. Du designar för exekveringsmodellen, annars kämpar du mot den hela tiden.
Bra arkitektur börjar med att välja rätt körmiljö för problemet, inte att falla tillbaka på den man är bekant med. För Shrtnrs arbetsbelastning — globalt distribuerade, latenskänsliga omdirigeringar med frågbar analys — var Cloudflare Workers det tydligaste valet, och appen designades för denna körmiljö från start.
Varför vi valde D1 framför KV (och varför det spelar roll)
Uppdatering (april 2026): vi har sedan dess lagt till KV som en write-through-cache framför D1 för den heta sökvägen för omdirigeringar. D1 är fortfarande källan till sanning för allt nedan; KV hanterar slug-upplösning vid edge. Läs uppföljningen →
Det här är ett av besluten som skiljer Shrtnr från alla andra URL-förkortare-guider du hittar online. Nästan varje "bygg en URL-förkortare på Cloudflare"-guide använder KV (Key-Value)-lagring. Det är logiskt för det enklaste fallet: lagra en slug-till-URL-mappning, slå upp den vid varje förfrågan, returnera en omdirigering.
Men KV är eventually consistent. Skrivningar sprids globalt, men inte omedelbart. Och när du behöver analys faller KV samman. Du kan inte fråga den. Du kan inte aggregera över dimensioner. Du kan inte fråga "visa mig klick per land de senaste 30 dagarna" eftersom KV inte stöder något som liknar en WHERE-sats.
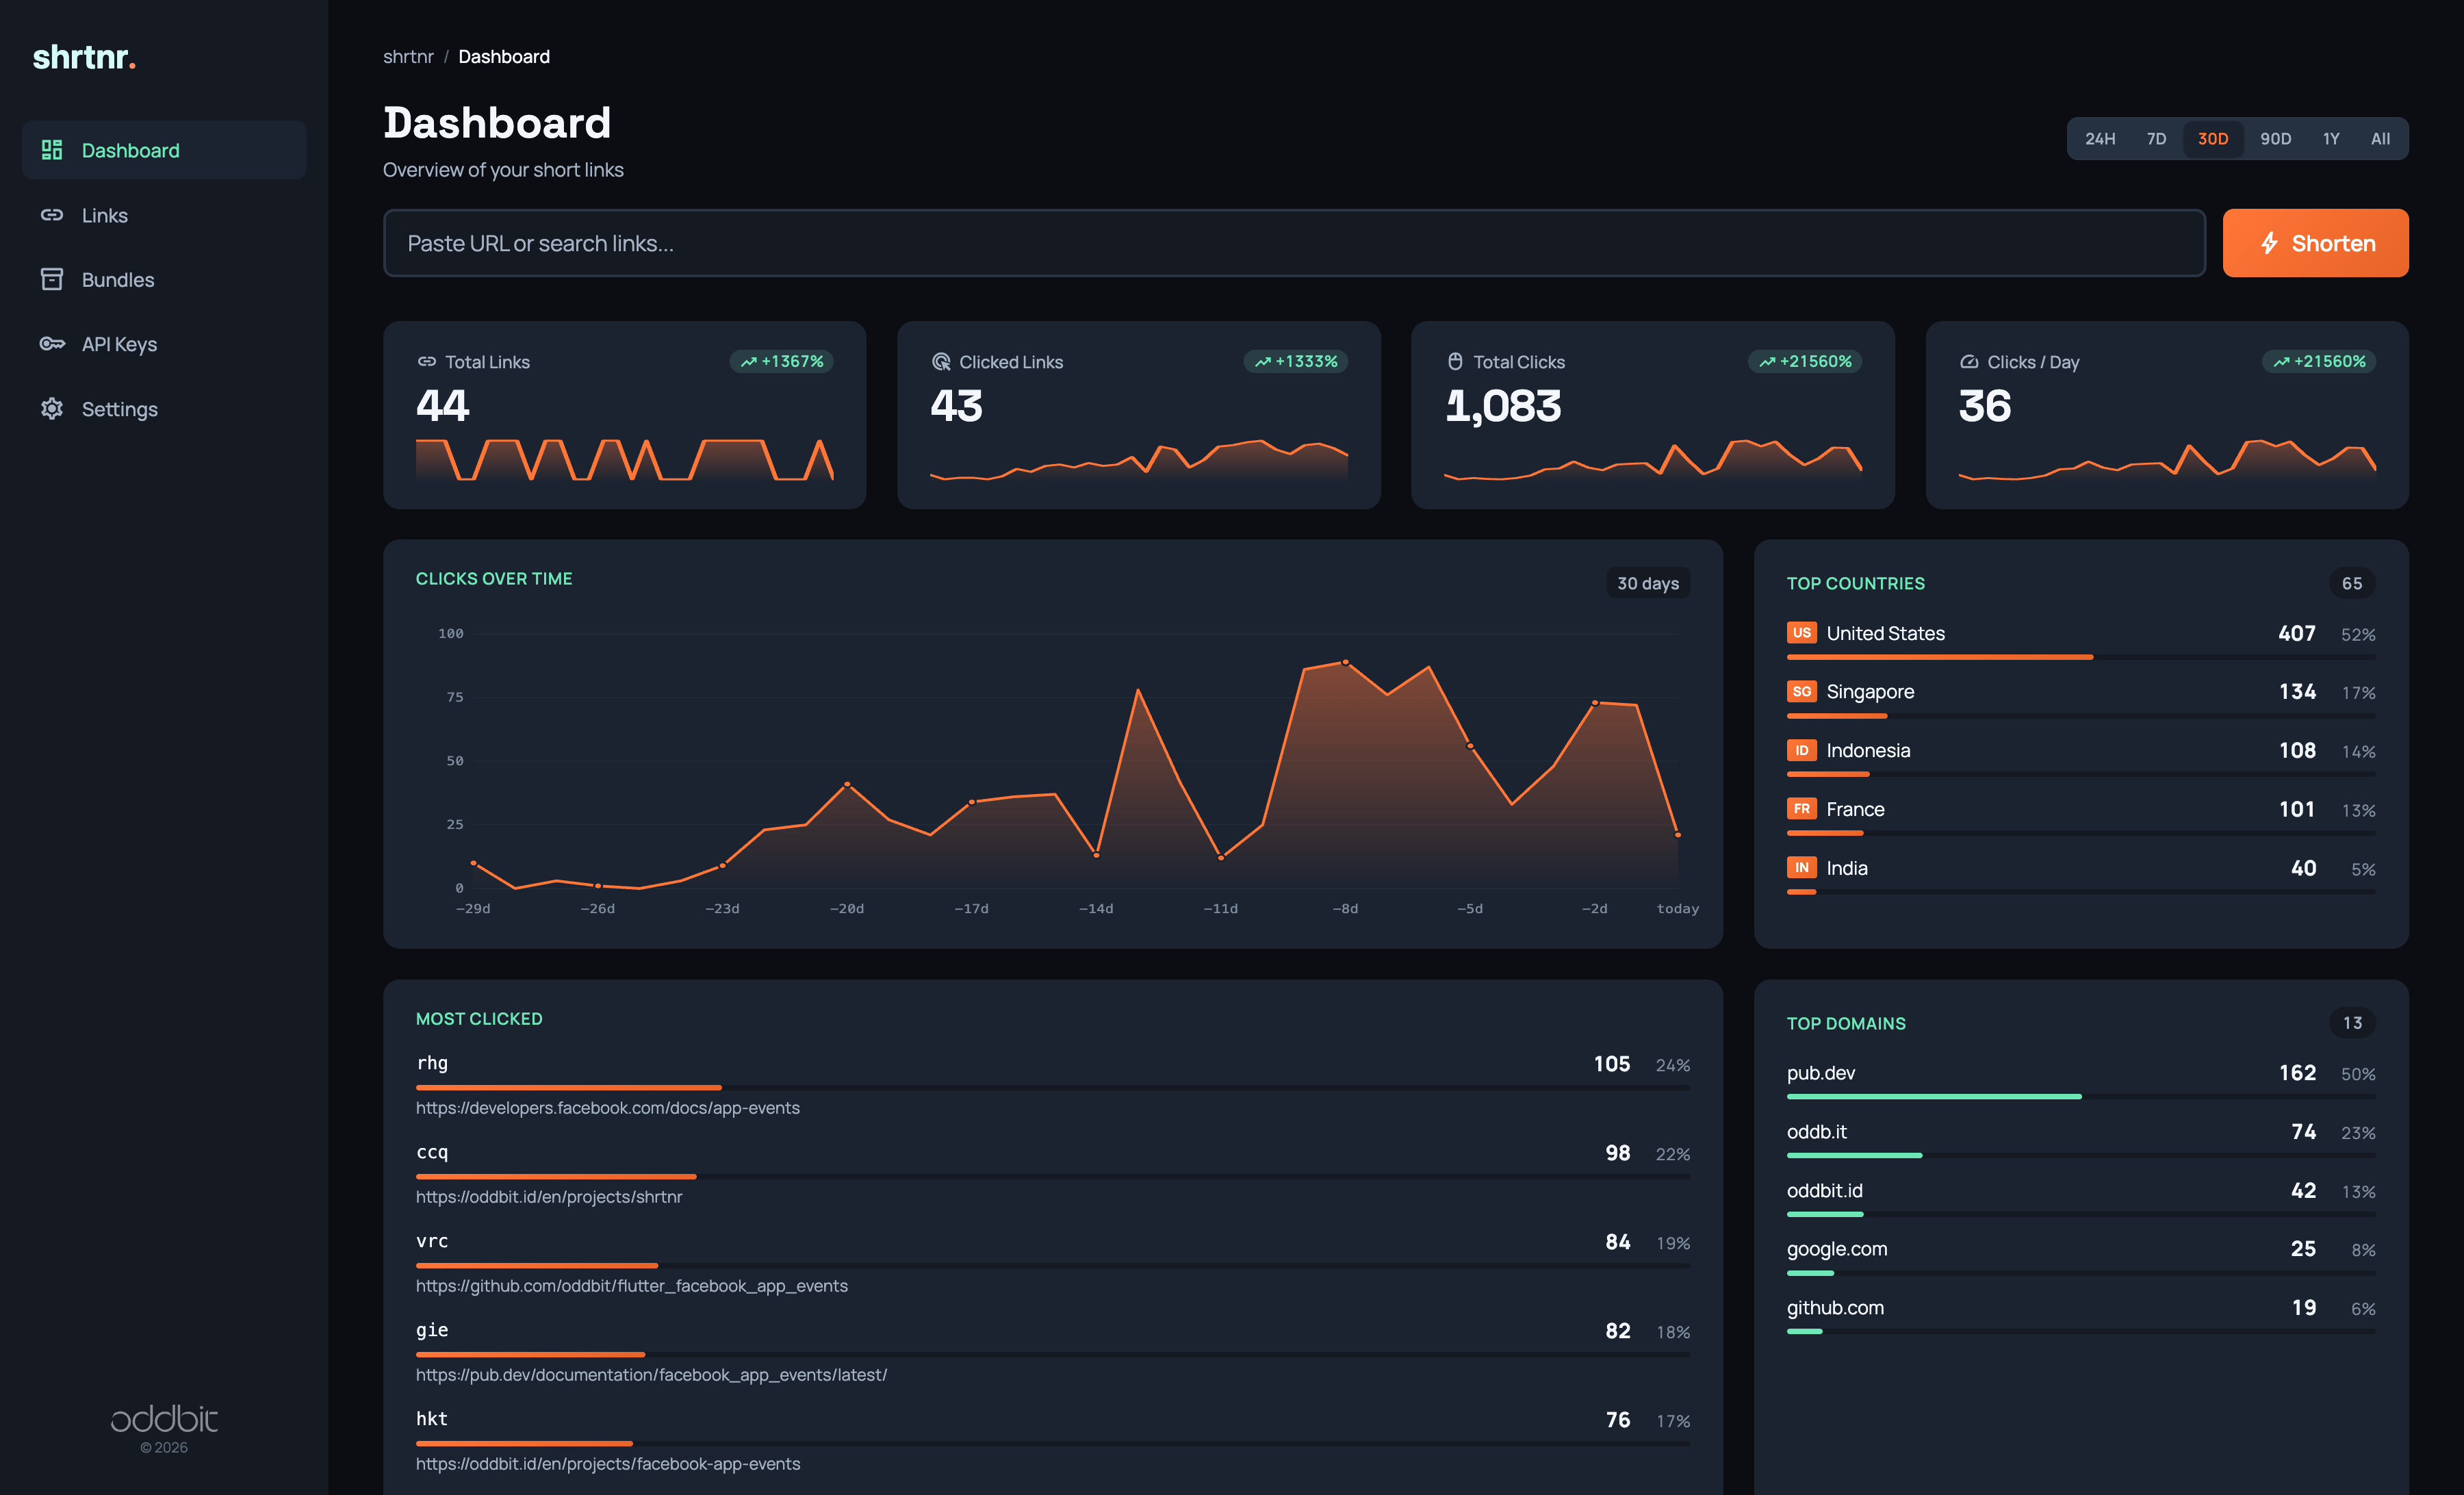
Shrtnr använder Cloudflare D1, som ger oss en SQLite-baserad relationsdatabasmodell som passar bra med Workers. Det ger oss relationella frågor, indexering och möjligheten att köra riktig analys på klickdata utan en separat analyspipeline. Länkuppslag, klickregistrering, tidsintervallfiltrering och flerdimensionell aggregering sker allt i D1, utan behov av en separat analyspipeline.
Vi indexerar tabellerna för de frågemönster som faktiskt spelar roll: slug-upplösning (den heta sökvägen vid varje omdirigering), tidsintervallfiltrering för analyspaneler och flerdimensionell aggregering över land, hänvisare, enhet, webbläsare och operativsystem.
För analys skickar Workern parallella frågor över alla fem dimensioner med Promise.all(). En API-förfrågan utlöser samtidiga D1-läsningar och sätter ihop resultatet. Inga bakgrundsjobb. Ingen köbearbetning. I måttlig skala fungerar detta bra och håller analysen i realtid. Vid väldigt hög trafik börjar de multipla frågorna per förfrågan äta in i D1:s dagliga läsgränser, och då vill man tänka på caching eller föraggregering. För vår användning är avvägningen värd det.
// Parallel analytics queries across all dimensions
const [countries, referrers, devices, browsers, os] = await Promise.all([
  db.prepare(`
    SELECT country, COUNT(*) as clicks
    FROM clicks
    WHERE link_id = ?
      AND clicked_at BETWEEN ? AND ?
    GROUP BY country
    ORDER BY clicks DESC
  `).bind(linkId, start, end).all(),
  db.prepare(`
    SELECT referrer, COUNT(*) as clicks
    FROM clicks
    WHERE link_id = ?
      AND clicked_at BETWEEN ? AND ?
    GROUP BY referrer
    ORDER BY clicks DESC
  `).bind(linkId, start, end).all(),
  db.prepare(`
    SELECT device_type, COUNT(*) as clicks
    FROM clicks
    WHERE link_id = ?
      AND clicked_at BETWEEN ? AND ?
    GROUP BY device_type
    ORDER BY clicks DESC
  `).bind(linkId, start, end).all(),
  db.prepare(`
    SELECT browser, COUNT(*) as clicks
    FROM clicks
    WHERE link_id = ?
      AND clicked_at BETWEEN ? AND ?
    GROUP BY browser
    ORDER BY clicks DESC
  `).bind(linkId, start, end).all(),
  db.prepare(`
    SELECT os, COUNT(*) as clicks
    FROM clicks
    WHERE link_id = ?
      AND clicked_at BETWEEN ? AND ?
    GROUP BY os
    ORDER BY clicks DESC
  `).bind(linkId, start, end).all(),
]);
Är D1 rätt val för varje projekt? Nej. KV är fortfarande bättre för enkla nyckeluppslag där du inte behöver relationella frågor. R2 är bättre för objektlagring. Durable Objects är bättre för tillståndsfull koordinering. Men för en produkt som behöver både snabba uppslag och frågbar analys är D1 verktyget som passar.
Hono: byggt för edge-körmiljöer, inte anpassat till dem
API-lagret är Hono, ett TypeScript-ramverk designat från grunden för edge-körmiljöer. Det här valet spelar större roll än det ser ut.
Express-liknande ramverk bär med sig antaganden om långlivade serverprocesser, middleware-kedjor och Node.js-specifika API:er. Du kan få dem att köra på Workers med adaptrar och kompatibilitetslager, men du spenderar tid på att jobba runt ramverket istället för att jobba med plattformen. Vi har gjort den sortens adapter-drivna arbete på andra plattformar tidigare. Det är aldrig kul, och specialfallen multipliceras.
Hono byggdes för den exekveringsmodell som Workers använder: kortlivade hanterare, inget filsystem, strikta minnesgränser. Det passar körmiljön på samma sätt som Rails passar en VPS. Inga adaptrar behövs.
Frontenden renderar server-side JSX genom Honos inbyggda stöd. Adminpanelen, länkdetaljsidor och inställningsgränssnittet genereras alla på edge och streamas till webbläsaren. Inget klient-side-ramverk. Ingen hydreringskostnad. Inget paket att ladda ner innan sidan blir interaktiv.
// Server-side rendered page at the edge
app.get("/links/:id", async (c) => {
  const link = await getLink(c.env.DB, c.req.param("id"));
  const analytics = await getAnalytics(c.env.DB, link.id);

  return c.html(
    <Layout title={link.label || link.url}>
      <LinkDetail link={link} analytics={analytics} />
    </Layout>
  );
});
Det här är ett av de beslut som kan verka smått, men som ackumuleras. Server-side rendering på edge innebär att första renderingen sker i samma förfrågan som resolvar sidan. Det finns ingen JavaScript-payload som blockerar renderingen. Panelen laddar snabbt på vilken uppkoppling som helst, i vilket land som helst, eftersom HTML:en sätts ihop nära användaren och skickas som en ström.
Ännu viktigare, det låter oss hålla hela appen i samma mentala modell: en Worker, ett ramverk, ett deployment-mål.
Vad händer härnäst
Det täcker arkitekturen: varför Workers, varför D1 istället för KV, och varför Hono istället för Express. I nästa inlägg tar vi upp produktionssidan: tre autentiseringssystem som körs i en enda Worker, deployment med ett klick, TypeScript SDK:n och vad det faktiskt kostar att köra detta i produktion (spoiler: det körs inom Cloudflares gratistier).
Om Oddbit
Vi är ett senior mjukvaruutvecklingsteam baserat på Bali, Indonesien, med rötter i Sverige. Vi bygger skräddarsydd programvara för startups och scale-ups: webbapplikationer, mobilappar, SaaS-plattformar och integrationerna som kopplar ihop dem. Våra kunder spänner över Norden, Europa och Sydostasien.
Shrtnr är ett av flera öppen källkod-verktyg vi har byggt och släppt. Andra inkluderar Tanam (ett Firebase-CMS med AI-innehållsgenerering), Flutter-paket med ungefär hundra tusen nedladdningar på pub.dev, och Firebase Genkit-plugins för AI-modellintegration.
Om du arbetar med ett tekniskt arkitekturbeslut, utvärderar edge computing för din produkt, eller bygger något från grunden, prata med oss. Vi visar hellre vårt arbete än berättar om det.